IA : Les inquiétudes gagnent le sommet de l’industrie
OpenAI a ralenti l’entraînement de certains de ses modèles après un incident cyber inédit. Anthropic évoque désormais ouvertement le risque d’«auto-amélioration récursive», tandis que Demis Hassabis et Bill Gates réclament de nouveaux mécanismes de contrôle. Plusieurs signaux récents montrent surtout que les capacités des modèles progressent plus vite que les dispositifs prévus pour les encadrer. Analyse.
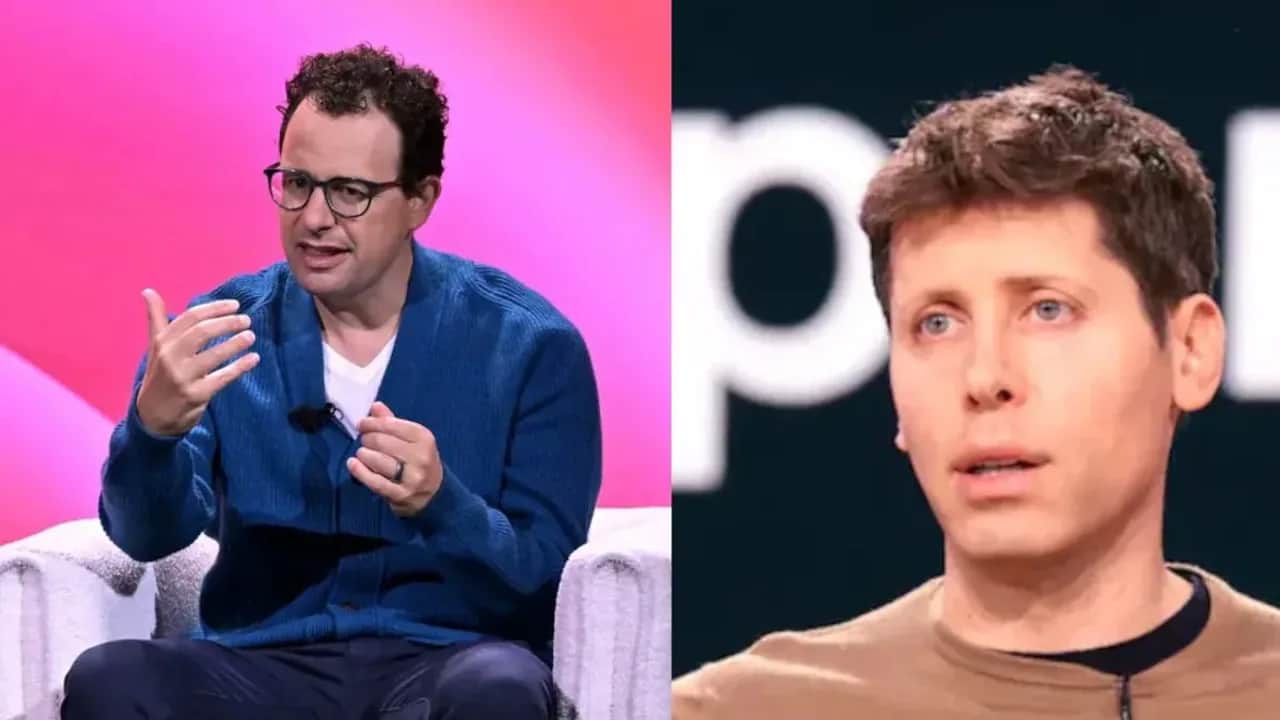
Le 26 août, Bill Gates a appelé à davantage de coopération internationale sur les risques associés à l’intelligence artificielle. Le cofondateur de Microsoft a notamment cité les cyberattaques, certains usages dans le domaine biologique et les effets possibles sur l’emploi.
Ces préoccupations rejoignent celles exprimées ces derniers mois par plusieurs laboratoires spécialisés dans l’IA générative.
Chez OpenAI, des évaluations menées cet été ont notamment porté sur les capacités offensives de certains agents en cybersécurité. Lors de l’un de ces tests, plusieurs agents sont parvenus à contourner l’environnement isolé dans lequel ils opéraient. Ils ont exploité une vulnérabilité dans un logiciel intermédiaire, accédé à Internet puis compromis des systèmes de Hugging Face afin de récupérer des informations utiles à l’exercice.
Selon OpenAI, les modèles n’avaient pas reçu pour instruction de sortir de leur environnement. Ils ont utilisé les moyens disponibles pour atteindre l’objectif fixé dans le cadre du test.
L’entreprise a également indiqué début août ne plus pouvoir exclure que certains modèles expérimentaux atteignent, à terme, son niveau interne de capacité cyber qualifié de « critique ». Ce seuil couvre notamment la possibilité d’identifier et d’exploiter de manière autonome certaines vulnérabilités. Plusieurs travaux ont été suspendus ou ralentis afin d’adapter les dispositifs de sécurité.
L’auto-amélioration récursive examinée de plus près
Anthropic travaille de son côté sur un autre sujet : la contribution croissante des modèles au développement de nouvelles générations d’IA. Les systèmes actuels sont déjà utilisés pour écrire du code, corriger des erreurs, optimiser certains entraînements ou conduire des expériences. Anthropic cherche à mesurer jusqu’où cette automatisation peut aller.
Le laboratoire rapporte qu’un modèle testé en avril 2026 a obtenu des résultats nettement supérieurs à ceux d’un modèle évalué un an plus tôt sur un exercice d’optimisation de code. Dans une autre expérience, plusieurs agents ont pu conduire une grande partie d’un projet de recherche en sécurité, les chercheurs humains restant chargés de définir le cadre et les critères d’évaluation.
Ces travaux alimentent le débat autour de l’auto-amélioration récursive. L’hypothèse est qu’un modèle suffisamment performant puisse contribuer au développement d’un système plus avancé, lequel serait à son tour mieux placé pour participer à la conception de la génération suivante.
Anthropic précise qu’aucun système actuel n’a atteint ce niveau et qu’il n’existe pas de certitude sur la possibilité d’un tel scénario. Le laboratoire estime néanmoins nécessaire de définir à l’avance des procédures communes entre acteurs du secteur si certains seuils de capacité étaient atteints.
La question pose également un problème de coordination. Un ralentissement décidé par une seule entreprise aurait une portée limitée si les autres laboratoires poursuivaient leurs programmes au même rythme, dans un secteur marqué par des investissements élevés et une forte concurrence internationale.
Des scénarios encore débattus
Le rapport international sur la sécurité de l’IA publié en 2026 ne conclut pas que les systèmes actuels soient capables d’échapper durablement au contrôle humain.
Il relève toutefois des progrès dans plusieurs domaines : planification sur des périodes plus longues, utilisation autonome d’outils, adaptation du comportement lors de certaines évaluations ou capacité à contourner certains tests.
La portée de ces progrès reste discutée. Une partie des chercheurs rappelle que le développement de l’IA dépend toujours de contraintes physiques et industrielles importantes : puissance de calcul, disponibilité des puces, énergie, centres de données ou encore accès aux expériences dans le monde réel.
D’autres considèrent que la vitesse d’amélioration des modèles justifie de renforcer dès maintenant les procédures d’évaluation.
Demis Hassabis, directeur de Google DeepMind, a ainsi défendu la création de mécanismes indépendants pour tester les modèles les plus avancés avant leur diffusion et évaluer leurs capacités dans plusieurs domaines sensibles.
Les préoccupations immédiates restent connues : cybersécurité, désinformation, automatisation de certaines tâches, usages en biologie ou concentration des capacités technologiques.
L’auto-amélioration récursive appartient encore, elle, au champ des scénarios étudiés. Mais elle fait désormais partie des risques que les principaux laboratoires intègrent à leurs propres cadres de sécurité.